Чому транспортування матриці 512x512 набагато повільніше, ніж транспонування матриці 513x513?


218

Провівши кілька експериментів на квадратних матрицях різної величини, вийшов візерунок. Незмінно переміщення матриці розміру 2^nвідбувається повільніше, ніж транспонування розміру2^n+1 . Для малих значень n, різниця не є основною.

Однак великі відмінності виникають над значенням 512. (принаймні, для мене)

Відмова: Я знаю, що функція насправді не переносить матрицю через подвійний підміна елементів, але це не має ніякої різниці.

Дотримується коду:

#define SAMPLES 1000
#define MATSIZE 512

#include <time.h>
#include <iostream>
int mat[MATSIZE][MATSIZE];

void transpose()
{
   for ( int i = 0 ; i < MATSIZE ; i++ )
   for ( int j = 0 ; j < MATSIZE ; j++ )
   {
       int aux = mat[i][j];
       mat[i][j] = mat[j][i];
       mat[j][i] = aux;
   }
}

int main()
{
   //initialize matrix
   for ( int i = 0 ; i < MATSIZE ; i++ )
   for ( int j = 0 ; j < MATSIZE ; j++ )
       mat[i][j] = i+j;

   int t = clock();
   for ( int i = 0 ; i < SAMPLES ; i++ )
       transpose();
   int elapsed = clock() - t;

   std::cout << "Average for a matrix of " << MATSIZE << ": " << elapsed / SAMPLES;
}

Зміна MATSIZEдозволяє нам змінити розмір (так!). Я розмістив дві версії на ideone:

У моєму середовищі (MSVS 2010, повна оптимізація) різниця схожа:

  • розмір 512 - середній 2,19 мс
  • розмір 513 - середній 0,57 мс

Чому це відбувається?


9
Ваш код мені виглядає недобросовісно кешем.
— CodesInChaos

7
Це в значній мірі те ж питання , як це питання: stackoverflow.com/questions/7905760 / ...
— Mysticial

Хочете розробити, @CodesInChaos? (Або хто-небудь інший.)
— corazza

@Bane Як щодо читання прийнятої відповіді?
— CodesInChaos

4
@nzomkxia Нічого не міряти нічого без оптимізацій. Якщо оптимізація вимкнена, генерований код буде засмічений стороннім сміттям, яке приховуватиме інші вузькі місця. (наприклад, пам'ять)
— Mysticial

Відповіді:


197

Пояснення походить від Agner Fog в програмі «Оптимізація програмного забезпечення в C ++» і зводиться до способу доступу та зберігання даних у кеші.

Терміни та детальну інформацію дивіться у вікі-статті про кешування , я скорочу її тут.

Кеш організований по наборах і рядках . Одночасно використовується лише один набір, з якого можна використовувати будь-який з рядків, які він містить. Лінія пам'яті, яка може відображати кількість разів, дає нам кількість кешу.

Для конкретної адреси пам'яті ми можемо обчислити, який набір повинен відображати її за формулою:

set = ( address / lineSize ) % numberOfsets

Така формула в ідеалі дає рівномірний розподіл по наборах, оскільки кожна адреса пам'яті, швидше за все, буде прочитана (я сказав в ідеалі ).

Зрозуміло, що можуть відбуватися перекриття. У разі пропуску кешу пам'ять в кеш-пам'яті зчитується, а старе значення замінюється. Пам'ятайте, що кожен набір має ряд рядків, з яких найменш використаний останній перезаписується щойно прочитаною пам'яттю.

Я спробую дещо наслідувати приклад з Агнера:

Припустимо, кожен набір має 4 рядки, кожен вміщує 64 байти. Спочатку ми намагаємося прочитати адресу 0x2710, яка йде в комплекті 28. І тоді ми також спробувати прочитати адреси 0x2F00, 0x3700, 0x3F00і 0x4700. Всі вони належать до одного набору. Перед читанням 0x4700усі рядки в наборі були б зайняті. Читаючи, що пам'ять вилучає існуючий рядок у наборі, рядок, який спочатку утримувався 0x2710. Проблема полягає в тому, що ми читаємо адреси, які є (для цього прикладу) 0x800один від одного. Це критичний крок (знову ж таки, для цього прикладу).

Критичний крок також можна розрахувати:

criticalStride = numberOfSets * lineSize

Змінні, розташовані на відстані criticalStrideабо множинні один від одного, змагаються за однакові лінії кеша.

Це частина теорії. Далі, пояснення (також Агнер, я пильно стежу за цим, щоб уникнути помилок):

Припустимо, матриця 64х64 (пам’ятайте, ефекти змінюються залежно від кешу) з кеш-пам'яттю 8 кб, 4 рядки на набір * розміром рядка 64 байти. Кожен рядок може містити 8 елементів у матриці (64-бітові int).

Критичним кроком буде 2048 байт, що відповідає 4 рядкам матриці (що є безперервним у пам'яті).

Припустимо, ми обробляємо рядок 28. Ми намагаємося взяти елементи цього рядка і поміняти їх елементами з стовпця 28. Перші 8 елементів рядка складають кеш-рядок, але вони перейдуть у 8 різних рядки кеша в стовпці 28. Пам'ятайте, критичний крок розташований на 4 ряди (4 послідовних елемента в стовпці)

Коли елемент 16 буде досягнутий у стовпці (4 рядки кешу на набір та 4 ряди один від одного = проблема), елемент ex-0 буде вилучений із кеша. Коли ми досягнемо кінця стовпця, всі попередні рядки кешу втратили б і потребували перезавантаження при доступі до наступного елемента (весь рядок буде перезаписано).

Маючи розмір, який не є кратним критичному кроку, псує цей ідеальний сценарій стихійного лиха, оскільки ми більше не маємо справу з елементами, які мають критичний крок на вертикалі, тому кількість перезавантажень кешу сильно зменшується.

Ще одна відмова від відповідальності - я просто взяв голову навколо пояснення і сподіваюся, що я його прибив, але я можу помилитися. У будь-якому разі я чекаю відповіді (або підтвердження) від Mysticial . :)


Ой і наступного разу. Просто пінг мені прямо через Лаунж . Я не знаходжу кожного екземпляра імені на SO. :) Я бачив це лише через періодичні сповіщення електронною поштою.
— Містичне

@Mysticial @Luchian Grigore Один з моїх друзів каже мені, що його Intel core i3ПК працює на Ubuntu 11.04 i386демонструє майже таку ж продуктивність з gcc 4.6. І так само для мого комп'ютера Intel Core 2 Duoз mingw gcc4.4 , який працює на windows 7(32). Він показує велику різницю, коли Я складаю цей сегмент з трохи старшим ПК intel centrinoз gcc 4.6 , який працює на ubuntu 12.04 i386.
— Hongxu Chen

Також зауважте, що доступ до пам'яті, де адреси відрізняються по кратності 4096, має помилкову залежність від процесорів сімейства Intel SnB. (тобто таке зміщення в межах сторінки). Це може зменшити пропускну здатність, коли деякі операції зберігаються, особливо суміш вантажів і магазинів.
— Пітер Кордес

which goes in set 24ти замість цього мав на увазі "у наборі 28 "? А ви припускаєте 32 набори?
— Руслан

Ви маєте рацію, це 28. :) Я також двічі перевірив зв'язаний папір, для оригінального пояснення ви можете перейти до організації кешу 9.2
— Luchian Grigore

78

Лучіан дає пояснення, чому така поведінка трапляється, але я подумав, що було б непоганою ідеєю показати одне можливе рішення цієї проблеми і в той же час показати трохи про кешовані алгоритми, що не знають кеш.

Ваш алгоритм:

for (int i = 0; i < N; i++) 
   for (int j = 0; j < N; j++) 
        A[j][i] = A[i][j];

що просто жахливо для сучасного процесора. Одне рішення - знати деталі щодо вашої кеш-системи та налаштувати алгоритм, щоб уникнути цих проблем. Чудово працює, доки ви знаєте ці деталі .. не особливо портативні.

Чи можемо ми зробити краще? Так, ми можемо: загальний підхід до цієї проблеми - це алгоритми, що не враховують кеш, які, як видно з назви, уникають залежності від конкретних розмірів кешу [1]

Рішення виглядатиме так:

void recursiveTranspose(int i0, int i1, int j0, int j1) {
    int di = i1 - i0, dj = j1 - j0;
    const int LEAFSIZE = 32; // well ok caching still affects this one here
    if (di >= dj && di > LEAFSIZE) {
        int im = (i0 + i1) / 2;
        recursiveTranspose(i0, im, j0, j1);
        recursiveTranspose(im, i1, j0, j1);
    } else if (dj > LEAFSIZE) {
        int jm = (j0 + j1) / 2;
        recursiveTranspose(i0, i1, j0, jm);
        recursiveTranspose(i0, i1, jm, j1);
    } else {
    for (int i = i0; i < i1; i++ )
        for (int j = j0; j < j1; j++ )
            mat[j][i] = mat[i][j];
    }
}

Трохи складніший, але короткий тест показує щось досить цікаве на моєму стародавньому e8400 з випуском VS2010 x64, тестовий код для MATSIZE 8192

int main() {
    LARGE_INTEGER start, end, freq;
    QueryPerformanceFrequency(&freq);
    QueryPerformanceCounter(&start);
    recursiveTranspose(0, MATSIZE, 0, MATSIZE);
    QueryPerformanceCounter(&end);
    printf("recursive: %.2fms\n", (end.QuadPart - start.QuadPart) / (double(freq.QuadPart) / 1000));

    QueryPerformanceCounter(&start);
    transpose();
    QueryPerformanceCounter(&end);
    printf("iterative: %.2fms\n", (end.QuadPart - start.QuadPart) / (double(freq.QuadPart) / 1000));
    return 0;
}

results: 
recursive: 480.58ms
iterative: 3678.46ms

Редагувати: Про вплив розміру: Це набагато менш виражено, хоча все ще помітно певною мірою, це тому, що ми використовуємо ітеративне рішення як вузол листів, а не повторюється до 1 (звичайна оптимізація для рекурсивних алгоритмів). Якщо ми встановимо LEAFSIZE = 1, кеш не впливає на мене [ 8193: 1214.06; 8192: 1171.62ms, 8191: 1351.07ms- це всередині межі помилки, коливання знаходяться в області 100 мс; цей "орієнтир" - це не те, що мені було б занадто комфортно, якби ми хотіли абсолютно точних значень])

[1] Джерела цього матеріалу: Ну, якщо ви не можете прочитати лекцію від того, хто працював з Лейзерсоном та співпрацював над цим. Ці алгоритми все ще описані досить рідко - CLR має єдину виноску про них. Все-таки це чудовий спосіб здивувати людей.


Редагувати (зауважте: я не той, хто опублікував цю відповідь; я просто хотів додати це):
Ось повна версія C ++ вищевказаного коду:

template<class InIt, class OutIt>
void transpose(InIt const input, OutIt const output,
    size_t const rows, size_t const columns,
    size_t const r1 = 0, size_t const c1 = 0,
    size_t r2 = ~(size_t) 0, size_t c2 = ~(size_t) 0,
    size_t const leaf = 0x20)
{
    if (!~c2) { c2 = columns - c1; }
    if (!~r2) { r2 = rows - r1; }
    size_t const di = r2 - r1, dj = c2 - c1;
    if (di >= dj && di > leaf)
    {
        transpose(input, output, rows, columns, r1, c1, (r1 + r2) / 2, c2);
        transpose(input, output, rows, columns, (r1 + r2) / 2, c1, r2, c2);
    }
    else if (dj > leaf)
    {
        transpose(input, output, rows, columns, r1, c1, r2, (c1 + c2) / 2);
        transpose(input, output, rows, columns, r1, (c1 + c2) / 2, r2, c2);
    }
    else
    {
        for (ptrdiff_t i1 = (ptrdiff_t) r1, i2 = (ptrdiff_t) (i1 * columns);
            i1 < (ptrdiff_t) r2; ++i1, i2 += (ptrdiff_t) columns)
        {
            for (ptrdiff_t j1 = (ptrdiff_t) c1, j2 = (ptrdiff_t) (j1 * rows);
                j1 < (ptrdiff_t) c2; ++j1, j2 += (ptrdiff_t) rows)
            {
                output[j2 + i1] = input[i2 + j1];
            }
        }
    }
}

2
Це було б актуально, якщо ви порівнювали часи між матрицями різного розміру, а не рекурсивними та ітераційними. Спробуйте рекурсивний розчин на матриці вказаних розмірів.
— Лучіан Григоре

@Luchian Оскільки ви вже пояснювали, чому він бачить свою поведінку, я вважав, що цілком цікавим є взагалі одне рішення цієї проблеми.
— Voo

Тому що я запитую, чому більша матриця займає коротший час для обробки, не шукаючи більш швидкого алгоритму ...
— Лучіан Григоре

@ Luuchian Різниці між 16383 та 16384 роками складають .. 28 проти 27 мс для мене тут, або приблизно 3,5% - не дуже важливі. І я був би здивований, якби це було.
— Voo

3
Це може бути цікаво пояснити, що recursiveTransposeробить, тобто, що він не заповнює кеш настільки, працюючи на невеликих плитках ( LEAFSIZE x LEAFSIZEрозмірності).
— Матьє М.

60

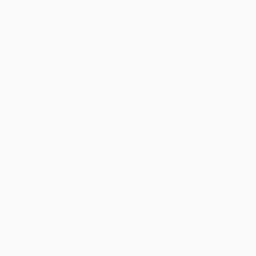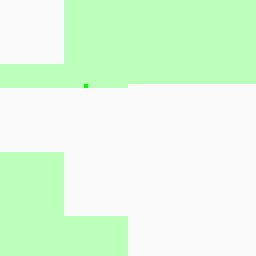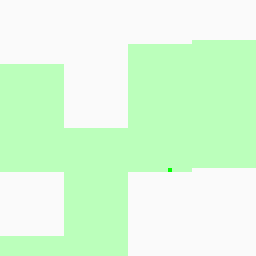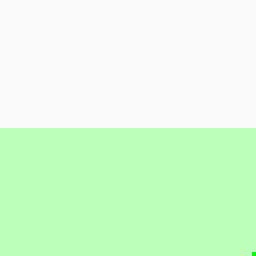
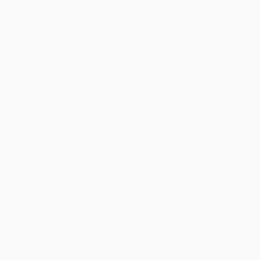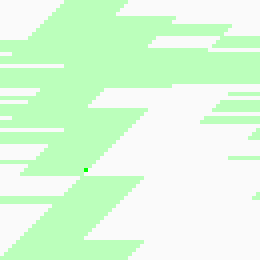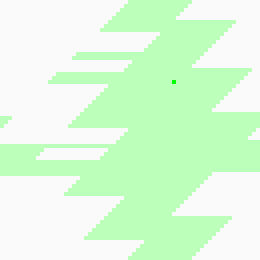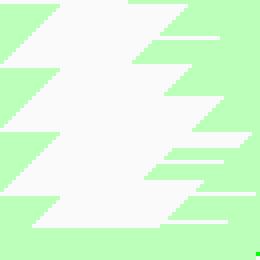
Як ілюстрацію до пояснення у відповіді Лухіяна Григора , ось як виглядає присутність кешового матриця для двох випадків матриць 64x64 та 65x65 (детальну інформацію про числа див. За посиланням вище).

Кольори в анімації нижче означають наступне:

  • білі - не в кеші,
  • світло-зелений - у кеші,
  • яскраво-зелений - кеш-хіт,
  • помаранчевий - просто читайте з оперативної пам’яті,
  • червоний - пропустіть кеш.

Корпус 64x64:

анімація присутності кеша для матриці 64x64

Зауважте, як майже кожен доступ до нового рядка призводить до пропуску кешу. А тепер, як це виглядає у звичайному випадку, матриці розміром 65x65:

анімація присутності кеша для матриці 65x65

Тут ви бачите, що більшість звернень після початкового розминки - це кешові звернення. Ось як кеш процесора повинен працювати в цілому.


Код, який генерував кадри для вищезазначених анімацій, можна побачити тут .


Чому звернення до кеша вертикального сканування не зберігаються в першому випадку, але у другому випадку? Схоже, що до даного блоку доступ доступний рівно один раз для більшості блоків в обох прикладах.
— Йосія Йодер

Я бачу з відповіді @ LuchianGrigore, що це тому, що всі рядки в стовпці належать до одного набору.
— Джосія Йодер

Так, чудова ілюстрація. Я бачу, що вони з однаковою швидкістю. Але насправді це не так, чи не так?
— келалака

@kelalaka так, FPS-анімація така ж. Я не імітував уповільнення, тут важливі лише кольори.
— Руслан

Цікаво було б мати два статичних зображення, що ілюструють різні набори кешу.
— Йосія Йодер
Використовуючи наш веб-сайт, ви визнаєте, що прочитали та зрозуміли наші Політику щодо файлів cookie та Політику конфіденційності.
Licensed under cc by-sa 3.0 with attribution required.